Frammentazione del viso e dataficazione del mondo: considerazioni a partire da un’analisi quali-quantitativa delle immagini di stock dell’intelligenza artificiale
Romele, Alberto, and Dario Rodighiero. 2022. “Frammentazione del viso e dataficazione del mondo: considerazioni a partire da un’analisi quali-quantitativa delle immagini di stock dell’intelligenza artificiale.” In Sguardi connessi: Prospettive sull’immagine e il mondo digitale, edited by Andrea Osti, 42–58. Milano: FrancoAngeli.
In questo articolo ci occupiamo delle immagini di stock che rappresentano l’intelligenza artificiale come un viso o un corpo che subisce un processo di frammentazione in particelle, pixel o voxel. Queste immagini, sosteniamo, sono i sintomi di una visione del mondo dataficata. Nella prima sezione discutiamo le immagini di stock dell’intelligenza artificiale e rendiamo conto delle nostre analisi quali-quantitative di circa 7.500 immagini tratte dal catalogo online di Shutterstock, che hanno fatto emergere visi e corpi in frammentazione come uno dei temi ricorrenti. Nella seconda sezione elaboriamo la nozione di dataficazione della visione del mondo, con alcuni esempi tratti dall’architettura e dal design, attraverso una deviazione metodologica che articola l’iconologia di Panofsky e la prospettiva “sintomatica” di Didi-Huberman. In conclusione, riflettiamo su un aspetto apparentemente marginale di queste immagini: l’uso abbondante del colore blu.
Introduzione
A dispetto del titolo forse troppo appariscente, in questo articolo vogliamo parlare di qualcosa di molto semplice, addirittura banale. Infatti, il nostro testo avrà al suo cuore le immagini di stock. Le immagini di stock sono quelle immagini pre-prodotte che possono essere acquistate sui siti internet di agenzie come Getty Images e Shutterstock, che a loro volta danno una certa somma a colui o colei che ha creato l’immagine. Le immagini di stock sono solitamente trascurate sia dal dibattito pubblico che dalla letteratura scientifica, perché vengono viste come la “carta da parati” della nostra cultura del consumo (Frosh 2003, 145). Quando considerate, esse sono invece semplicemente ridicolizzate per la loro maniera fortemente stereotipata di rappresentare la realtà. Esistono collezioni online di immagini di stock rappresentanti donne che ridono (chissà perché) mentre mangiano un’insalata,1 o ancora di donne che (questo si sa bene il perché) sembrano avere difficoltà a bere da una bottiglia d’acqua senza versarsene un po’ addosso.2 Eppure, le immagini di stock sono praticamente ovunque: le brochure dei corsi di laurea sono piene di ragazzi di successo, sdraiati su prati verdi o che lanciano in aria il tocco; i magazine abbondano di uomini d’affari, super indaffarati ma sorridenti, muscolosi senza dubbio ma con occhiali, etc. Tra l’altro, si può notare en passant come molti di questi cliché abbiano contribuito a importare o almeno rendere familiari a noi europei stili di vita che appartengono piuttosto alla cultura statunitense. Potremmo dire che l’influenza delle immagini di stock è tanto forte sulle nostre vite quanto quella del cinema hollywoodiano. Per questo, a dispetto della loro banalità e del loro essere profondamente kitsch, anzi proprio per questi motivi, le immagini di stock meritano tutta la nostra attenzione. Ovviamente, non siamo i primi a renderci conto dell’importanza delle immagini di stock, e una letteratura, ancora marginale ma crescente, si può trovare soprattutto nell’ambito della sociologia della comunicazione (Frosh 2013; Aiello e Woodhouse 2016; Thurlow, Aiello e Portmann 2020).
Nel nostro caso, non vogliamo però occuparci delle immagini di stock in generale. Quel che ci interessa sono piuttosto le immagini di stock che rappresentano tecnologie emergenti e, ancora più nello specifico, quelle che sono utilizzate per rappresentare visualmente l’intelligenza artificiale. Esiste in effetti un grande vuoto nella letteratura a questo proposito, sia per quel che riguarda la filosofia della tecnica, sia per quel che riguarda gli studi su scienza e tecnologia. Ancora più nello specifico, non ci interessiamo qui a tutte le immagini di stock dell’intelligenza artificiale, ma a un caso ben particolare, ovvero quelle immagini di stock in cui l’intelligenza artificiale è rappresentata come un viso (o un corpo), solitamente femminile o androgino, che subisce un processo di composizione e decomposizione in particelle. Sono queste le immagini a cui facciamo riferimento quando parliamo di “frammentazione del viso”. La nostra tesi è che queste immagini siano i sintomi di una “dataficazione” del mondo, o meglio delle sue visioni o concezioni, nel senso della Weltanschauung (visione o concezione del mondo) di autori come Dilthey e Mannheim o nel senso della Weltbild (immagine del mondo) di cui parla Wittgenstein (Romele 2014). La visione del mondo “a dati” è una maniera di percepire, agire e desiderare cose del mondo che emerge oggi come alternativa a visioni del mondo che hanno dominato nel passato, come quella meccanicistica o quella informazionale.
L’articolo si sviluppa in due sezioni. Nella prima sezione, parleremo di immagini di stock dell’intelligenza artificiale e renderemo conto delle nostre analisi quali-quantitative. Sono proprio queste analisi che hanno fatto emergere i visi e i corpi in frammentazione come uno dei temi ricorrenti tra le immagini di stock dell’intelligenza artificiale. Questa prima sezione implica anche una riflessione sulla rappresentabilità dell’intelligenza artificiale in quanto tale. Nella seconda parte, faremo di queste immagini dei sintomi di qualcosa di “epocale”, appunto una visione del mondo emergente. Questa seconda parte implica anche alcune riflessioni sul metodo proposto, ispirato tanto all’iconologia di Erwin Panofsky quanto alla critica mossa da Georges Didi-Huberman all’iconologia panofskiana. Nella conclusione, faremo ricorso proprio a Didi-Huberman (questa volta grazie alle sue considerazioni su Fra Angelico), per riflettere su un aspetto apparentemente marginale di queste immagini solitamente messe al margine delle nostre considerazioni: il colore blu.
Frammentazione del viso
Discipline come la filosofia della tecnica e gli studi su scienza e tecnologia si occupano da tempo delle immagini della scienza e della tecnica. Ci sono almeno due ragioni che hanno spinto queste discipline verso le immagini. La prima consiste nel fatto che portare le immagini in avanti significa portare in avanti il ruolo delle tecnologie nello sviluppo del sapere scientifico. Insomma, parlare di immagini ha l’effetto di mostrare come la scienza sia sempre più, ormai in maniera cronica, dipendente dall’uso di strumentazione tecnica, come appunto quelle tecnologie che producono immagini di oggetti e fenomeni che altrimenti resterebbero inaccessibili. In questo modo, si può decostruire la gerarchia classica che fa della tecnica un’applicazione del sapere scientifico, una sua conseguenza e infine un’ancella. Le tecnologie visuali (cioè che permettono la visione in ambito scientifico, come microscopi e telescopi, ecografia, e tutti gli strumenti che riguardano la visualizzazione di dati) sono ermeneutiche, nel senso che offrono una rappresentazione del mondo che deve essere correttamente interpretata e compresa per accedere a quella parte del mondo.3 La seconda ragione coincide con la proposta di superare il logo- e testo-centrismo che ha caratterizzato buona parte della filosofia del Novecento. Si pensi a questo proposito a Latour, secondo il quale il merito delle filosofie e delle teorie del linguaggio del ventesimo secolo è stato quello di dare finalmente dignità ai mediatori, che non sono più visti come dei semplici veicoli che portano il significato dall’umano al mondo o viceversa. Eppure, il loro limite è di aver fatto del linguaggio il solo mediatore, o almeno il modello per ogni altra mediazione (Latour 2015). Ecco, non è un caso allora che l’ermeneutica si sia sviluppata come teoria della mediazione linguistica (si pensi a Heidegger e Gadamer) o testuale (si pensi a Ricoeur), laddove testo e linguaggio sono solo due delle tecnologie ermeneutiche di cui gli umani dispongono. L’ermeneutica visuale, laddove non riduce l’immagine al testo e al linguaggio, o usa il modello linguistico come strumento per leggere l’immagine (si tratta, a dire il vero, di cose non del tutto scontate), sfugge proprio a questa tendenza a ridurre interpretazione e comprensione del mondo a un affare di linguaggio.
Ora, nonostante un acceso interesse per le immagini da parte di queste discipline, è interessante osservare come ci sia anche un grande vuoto. Da una parte, ci si è interessati infatti alle immagini prodotte da scienziati per altri scienziati, via l’utilizzo, come dicevamo prima, di strumentazione tecnica (Lynch e Woolgar 1990; Coopmans et al. 2014). Dall’altra parte, ci si è interessati anche alla produzione di immagini scientifiche da parte di artisti (si pensi alle artist’s impressions), per lo più in collaborazione con scienziati (Jones e Galison 1998). Sembra insomma che l’attenzione dei ricercatori vada verso quelle immagini che si trovano sotto l’egida di due giochi di verità: quello della referenza scientifica, da una parte, e quello del gusto estetico, dall’altra. Beninteso, poco importa qui che la referenza sia accettata in maniera naïve o sia criticata in maniera anche troppo accesa, fino a essere negata; così come poco importa se il gusto estetico, laddove applicato alla scienza, possa essere ancora disinteressato (come vorrebbe la tradizione kantiana) oppure meno. Il fatto è che in entrambi i casi la discussione e l’interesse rimangono all’interno di questi due ordini di verità, siano essi abbracciati o negati, e dunque d’immagine. In questo modo, tuttavia, tra la Scilla delle immagini della scienza e la Cariddi delle immagini artistiche, ciò che non passa, e che per questo viene escluso, sono tutte quelle immagini della scienza e della tecnica che non sono prodotte da scienziati e che non hanno particolare pretesa artistica. Si tratta di immagini popolari e volgari, artigianali più che artistiche, le quali hanno una storia che precede e va oltre quella delle sole immagini di stock ma che nella proliferazione di immagini di stock della scienza e della tecnica sembrano avere oggi la loro gloria.
In questo contesto, le immagini di stock che ci interessano sono quelle dell’intelligenza artificiale. Prima di entrare nel merito, vorremmo però discutere brevemente della rappresentabilità dell’intelligenza artificiale in quanto tale. Quando oggi si parla d’intelligenza artificiale, ci si riferisce per lo più a degli algoritmi di machine learning.4 Ora, la nostra idea è che ci siano tre modi di rappresentabilità dell’intelligenza artificiale d’oggi: (1) il primo è secondo l’algoritmo (che a sua volta è “incarnato” in un codice, in un albero decisionale, etc.).5 Si tratta tuttavia di una rappresentazione insoddisfacente, sia perché difficilmente comprensibile da un pubblico non-esperto, sia e soprattutto perché rappresentare l’algoritmo non significa certamente rappresentare l’intelligenza artificiale. Sarebbe come dire che basta rappresentare i neuroni per avere di fronte a sé la mente o lo spirito, tesi che nemmeno il riduzionismo più forte sembra disposto ad accettare; (2) il secondo è attraverso le “incarnazioni” dell’algoritmo in tecnologie come i robot, i droni, i veicoli autonomi, etc. Anche in questo caso, tuttavia, si tratta di una rappresentazione insoddisfacente, perché ciò che è rappresentato non è l’intelligenza artificiale ma la tecnologia in cui essa è supposta trovarsi; (3) il terzo è quel modo che rinuncia alla referenza alle cose stesse e predilige invece un riferimento alle attese di senso o agli immaginari che si hanno o si dovrebbero avere nei confronti di quella cosa. Anche questa rappresentazione è insoddisfacente, anzi è la più insoddisfacente di tutte secondo una logica referenzialista. Questa triplice distinzione è ovviamente idealtipica, nel senso che spesso e per lo più questi tre livelli tendono a confondersi tra loro. Per esempio, le linee di codice vengono colorate, il drone vola su prati verdi, il robot è perfettamente, troppo liscio e bianco, e anche le immagini più astratte fanno vagamente riferimento a quel che esiste o si fa: uno schermo touch, una rete neuronale, etc. Ciò che vogliamo qui suggerire tuttavia è che non si deve pensare che uno di questi tre modi sia per essenza da preferire all’altro quando si tratta di rappresentare un fenomeno complesso come quello dell’intelligenza artificiale. D’altronde, ciò significherebbe ridurre l’intelligenza artificiale a un fatto tecnico e materiale, riservato agli esperti, quando invece è ormai un fatto sociale e culturale. Non bisogna per esempio credere che il primo modo sia per essenza da preferire al secondo, e che il secondo sia comunque meglio del terzo perché più vicino alla cosa stessa. Bisogna invece dire che ognuno di questi livelli ha un’esistenza legittima e che, all’interno di questa esistenza legittima, è necessario individuare delle regole di verità. Nel caso delle immagini di stock dell’intelligenza artificiale, ci troviamo per lo più nel terzo modo di rappresentabilità. Ciò significa che queste immagini non possono essere giudicate sulla base della loro mancanza di referenza (altrimenti non ci resterebbe che buttarle via tutte) ma semmai sulla loro capacità o incapacità di riflettere la complessità delle attese di senso, delle speranze e delle paure, degli immaginari che dei gruppi di persone, siano esse esperte o non-esperte, siano esse direttamente interessate e impegnate nel tema oppure no, si fanno attorno all’intelligenza artificiale malgrado la sua difficile accessibilità.
Cercate su un motore di ricerca qualsiasi “intelligenza artificiale”. Selezionate l’opzione “immagini”. Come risultato, avrete cervelli metà carne e metà circuito, robot umanoidi che guardano e toccano schermi interattivi, linee di codice che viaggiano nello spazio e qualche variazione de La creazione di Adamo di Michelangelo in versione umano-robot.
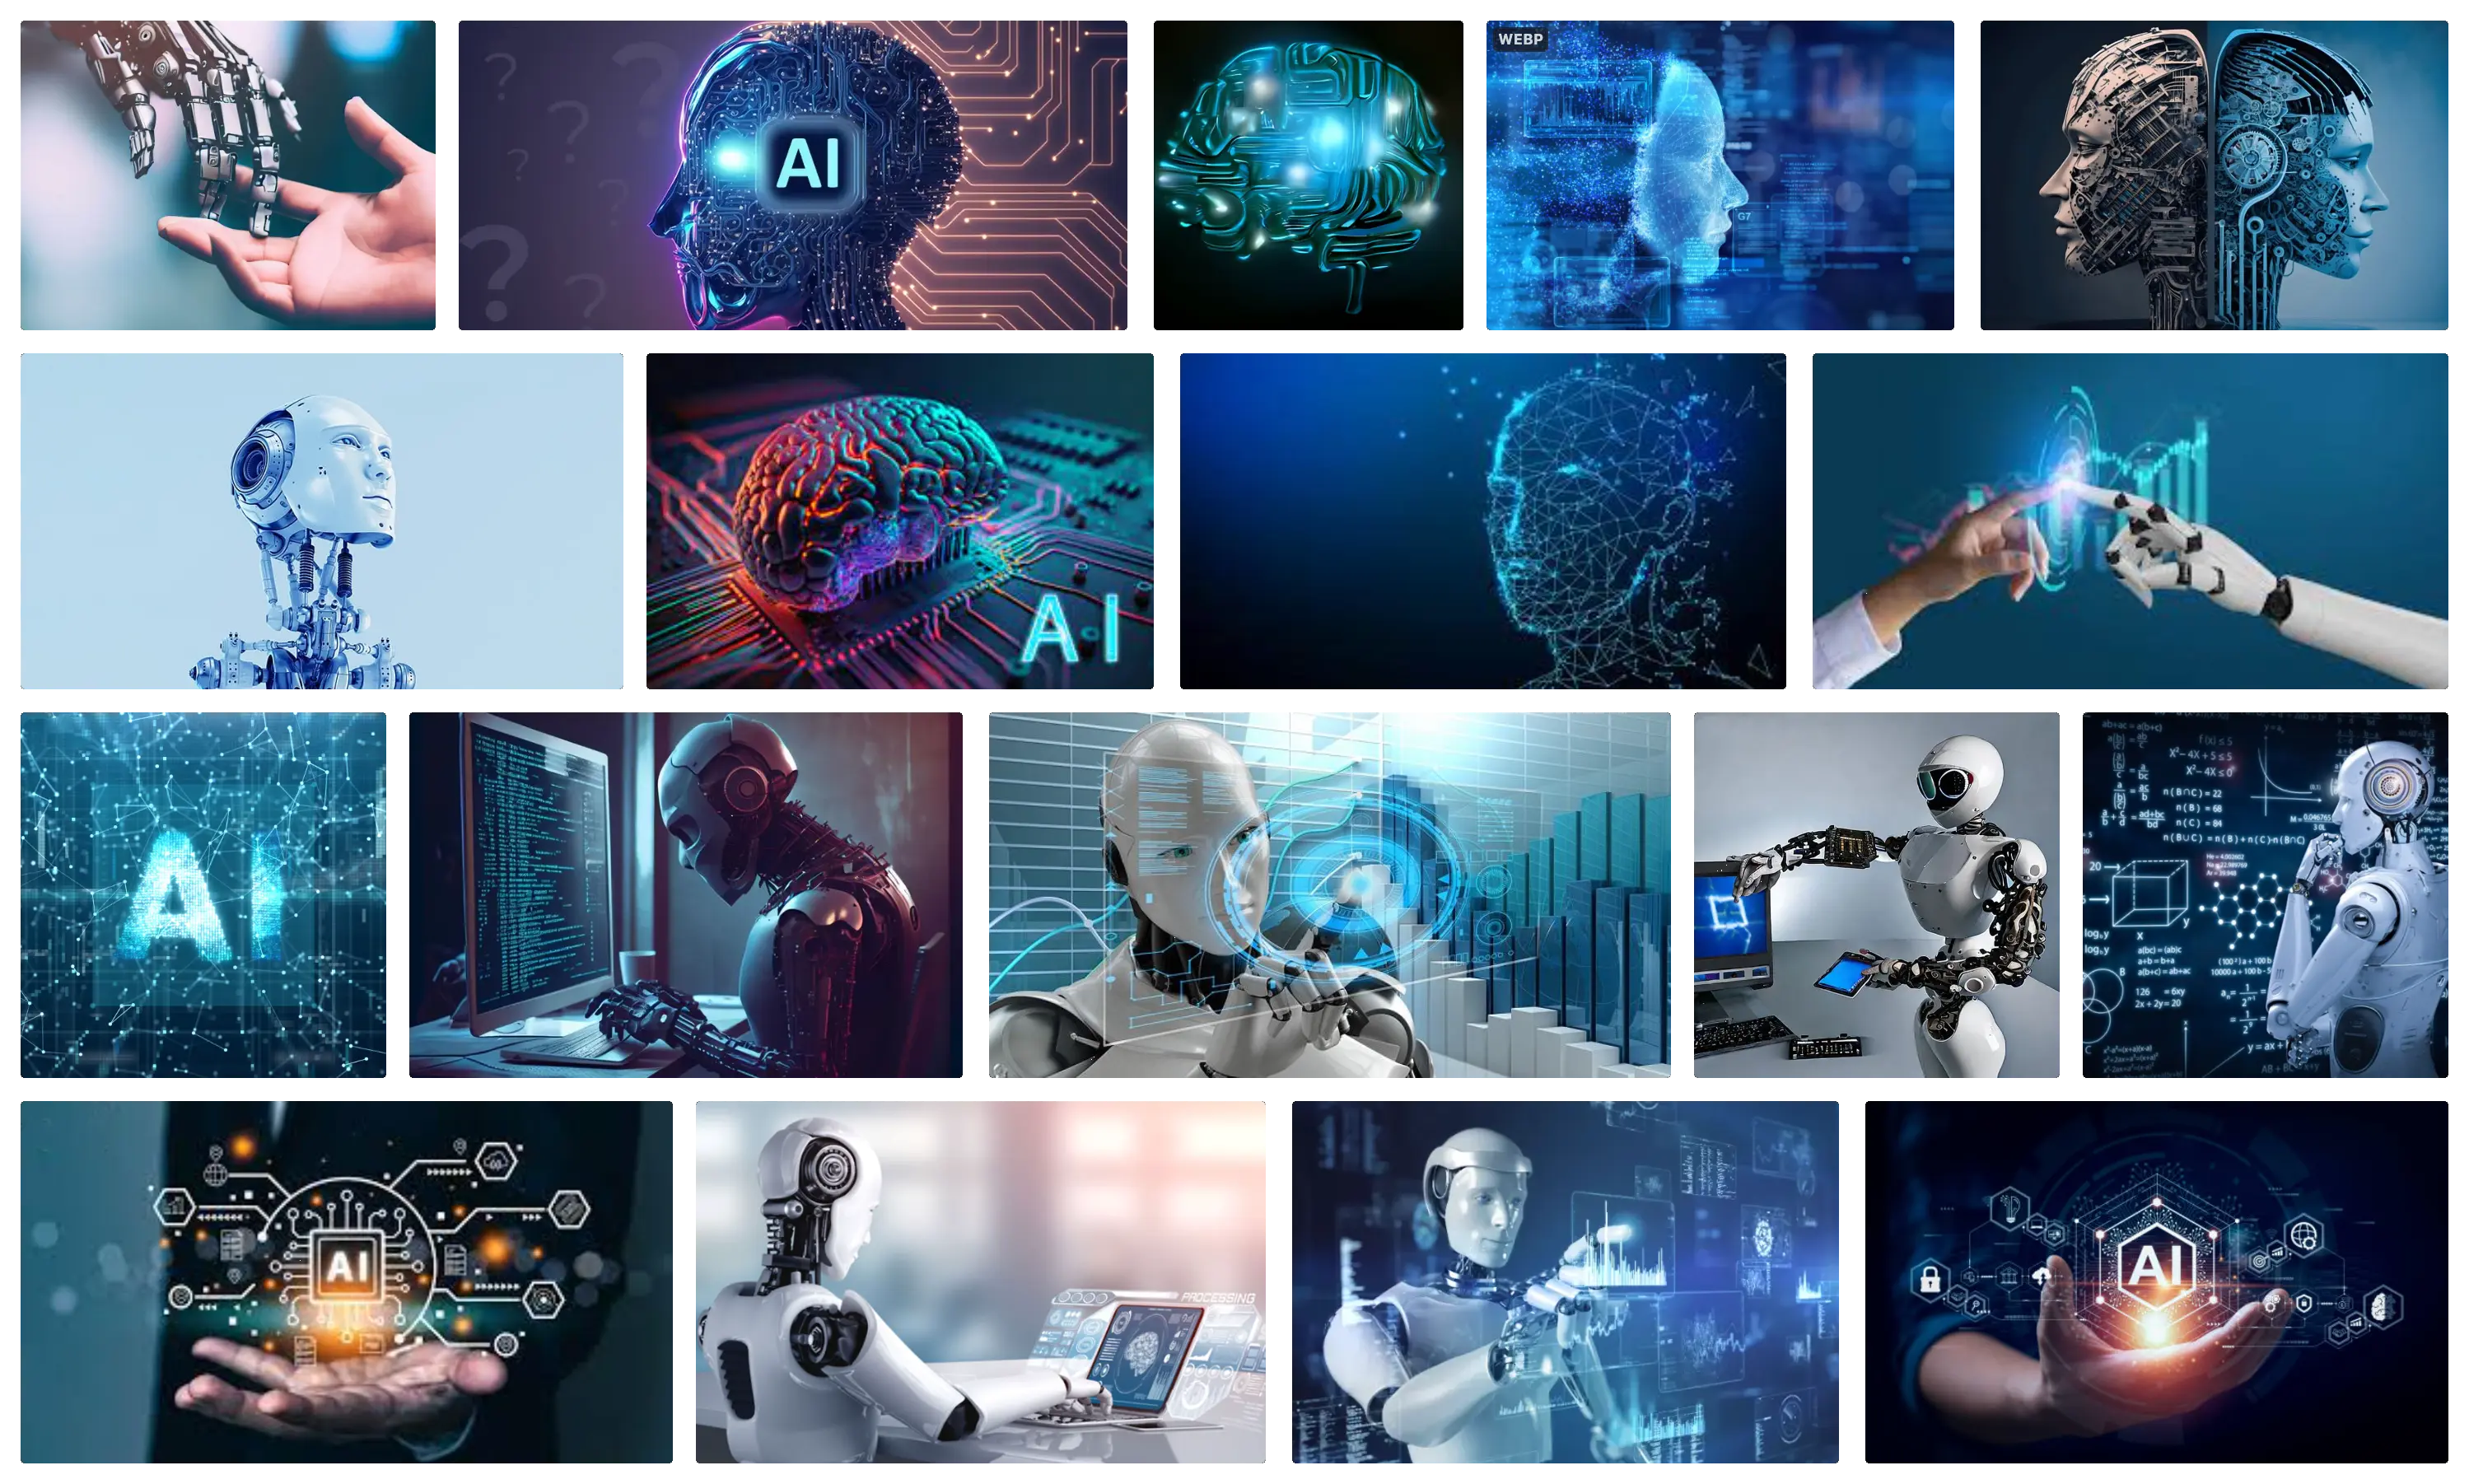
La maggior parte di queste immagini sono immagini di stock. Esiste un interesse crescente nei confronti della maniera in cui l’intelligenza artificiale è visualmente rappresentata oggi in maniera per lo più impropria. Alcune iniziative e progetti sono specificamente dedicati al tema.6 Anche noi abbiamo iniziato da qualche tempo a collezionare, via un profilo Instagram dal nome “ugly.ai”, immagini di stock dell’intelligenza artificiale utilizzate in contesti di comunicazione e marketing scientifico: copertine di libro, annunci di corsi e conferenze, pagine relative a formazioni e progetti di ricerca, etc.7 I casi più interessanti a questo proposito sono senza dubbio quelli in cui si parla di etica dell’intelligenza artificiale ma in cui l’etica della comunicazione scientifica visuale non è stata evidentemente presa in conto. Giusto per citare tre casi, le immagini con i link in nota si riferiscono rispettivamente alla copertina dell’Oxford Handbook of Ethics of AI,8 alla pagina dismessa della piattaforma europea Futurium da cui era possibile scaricare gli “Orientamenti etici per un’IA affidabile”9 e al sito del progetto SHERPA,10 che si presenta come “un progetto finanziato dall’UE che analizza come l’IA e l’analisi dei big data hanno un impatto sull’etica e sui diritti umani”.11 Non abbiamo spazio qui né per descrivere le immagini, né per spiegare le ragioni che ci portano a pensare che siano eticamente problematiche. Speriamo tuttavia che questo articolo possa offrire degli strumenti che saranno poi utili al lettore che vorrà tornare su tali immagini.
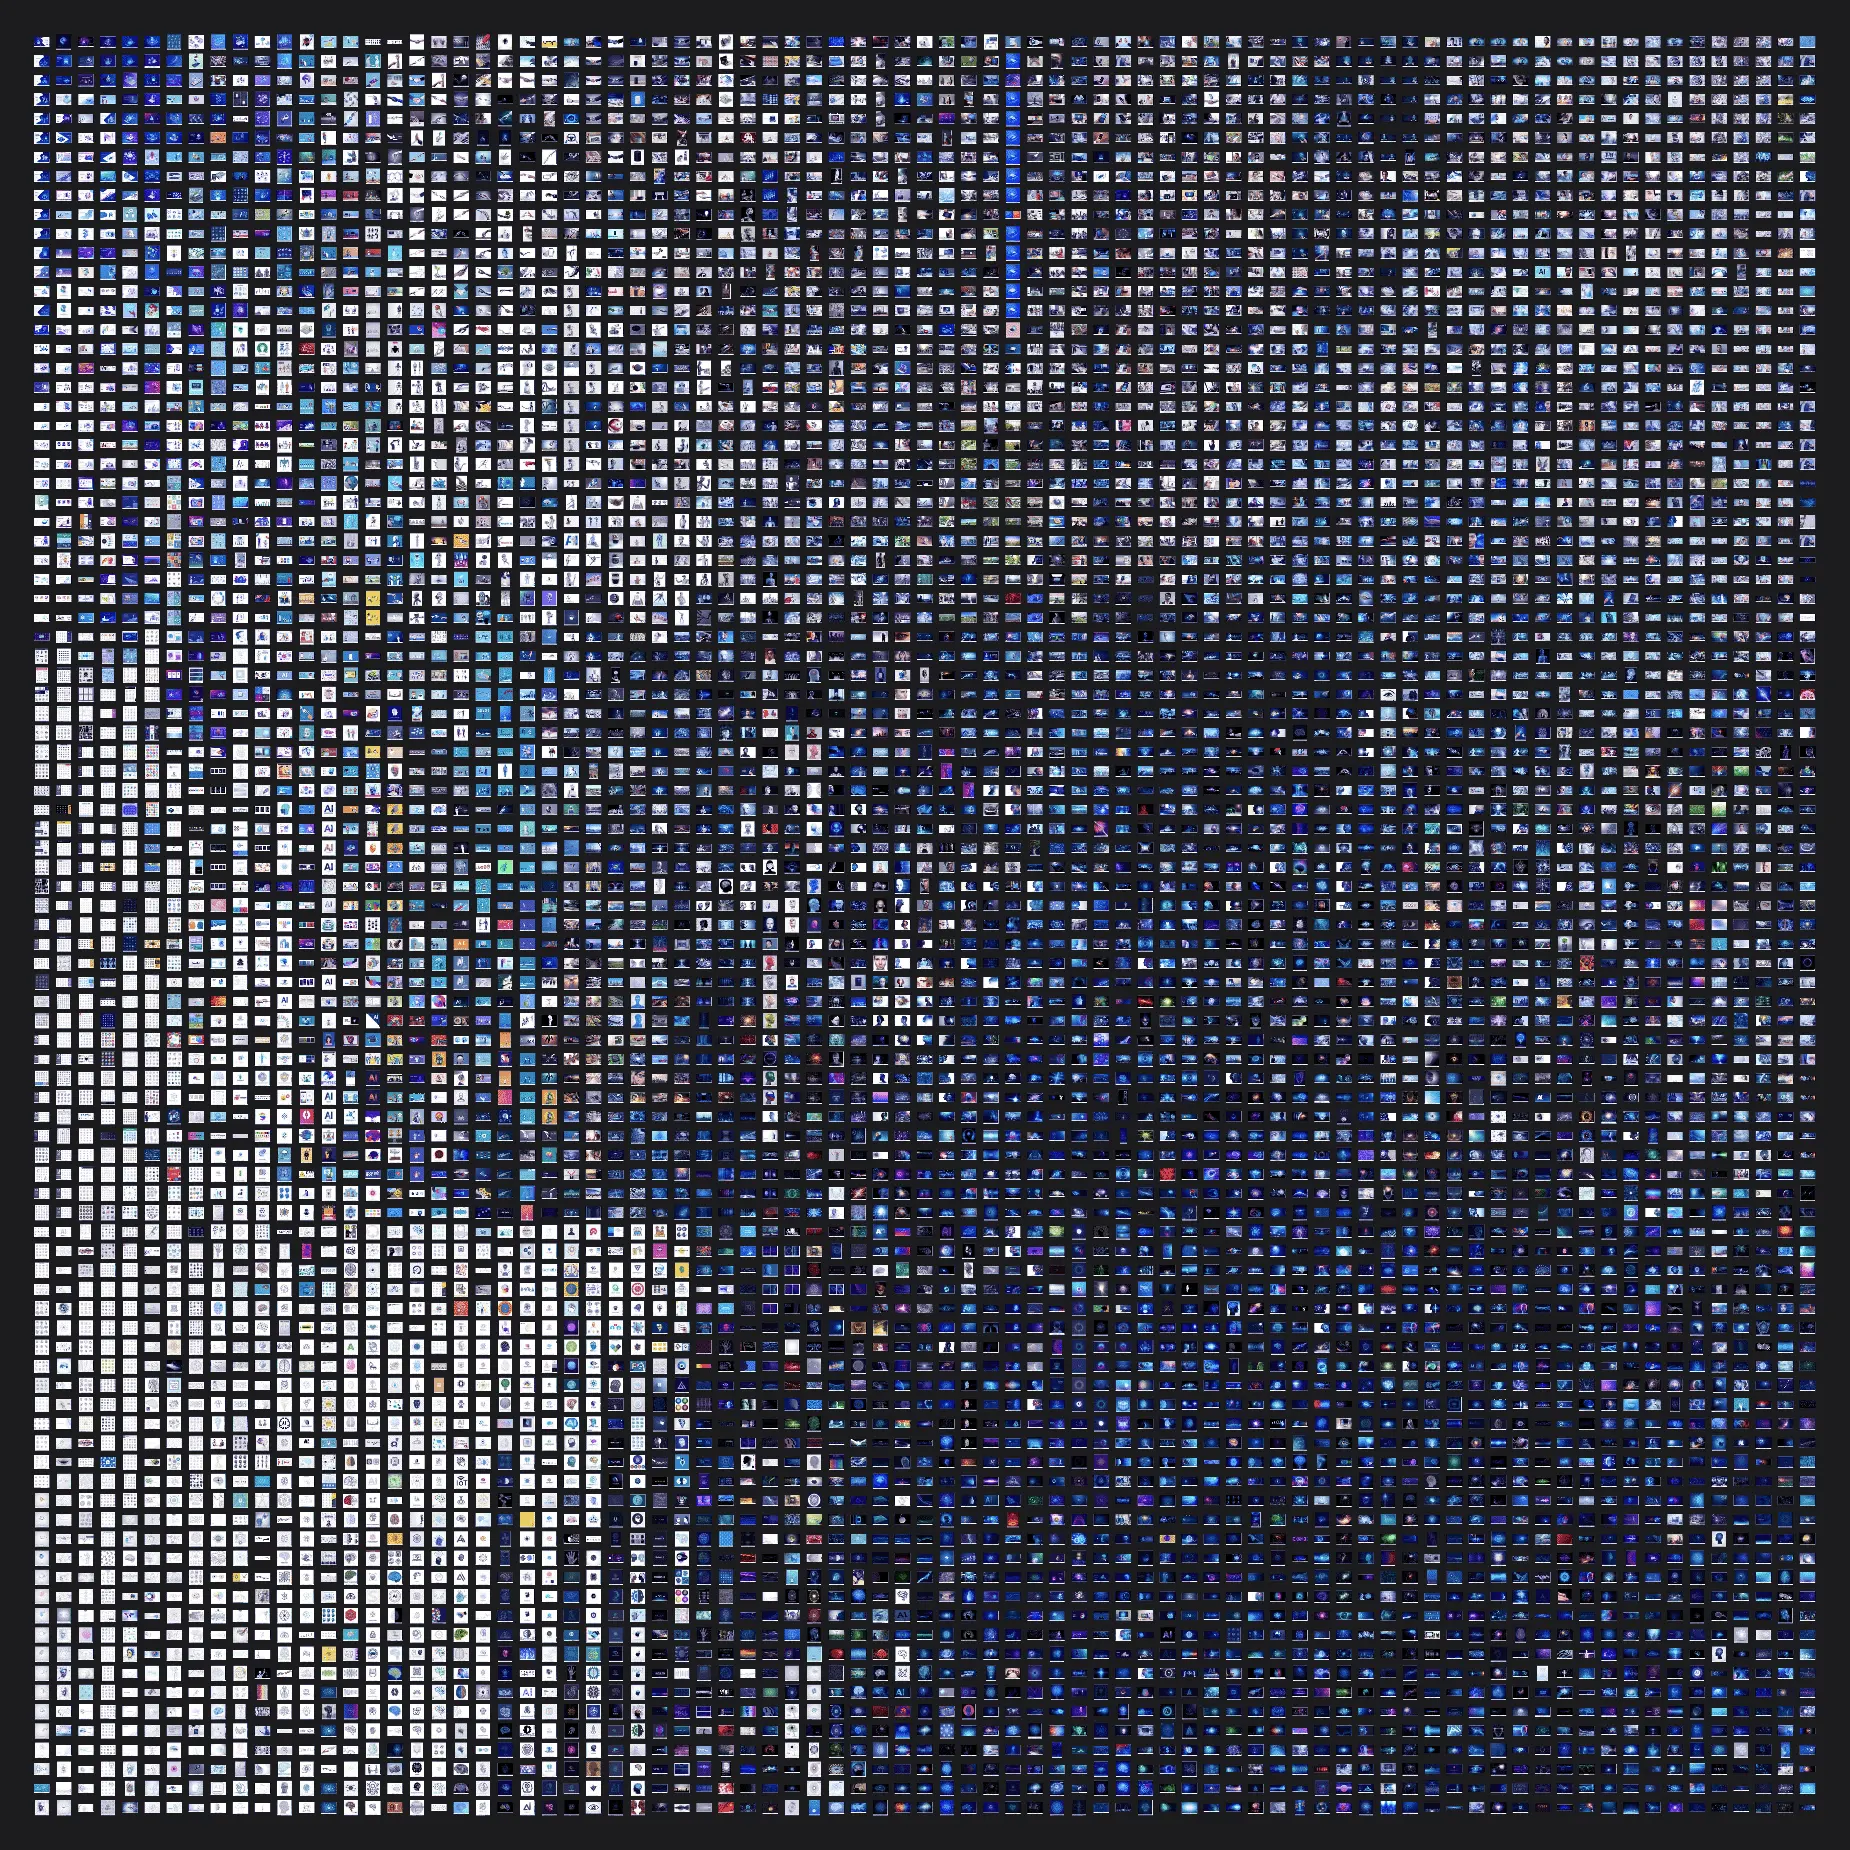
Di immagini di stock dell’intelligenza artificiale ce ne sono migliaia, sicuramente troppe. Per esempio, il motore di ricerca di Shutterstock dà in questo momento (ottobre 2021) 383.960 risultati per la ricerca “artificial intelligence”. Proprio con l’intento di andare oltre una mera analisi qualitativa di un esiguo numero di queste immagini, senza per questo dovere arrivare a un’analisi esaustiva, abbiamo deciso nelle nostre ricerche di fare ricorso ad alcuni metodi automatizzati. Per prima cosa, abbiamo utilizzato il web crawler Shutterscrape, che permette di scaricare in maniera massiva immagini e video da Shutterstock.12 Questo ci ha permesso di ottenere circa 7.500 immagini di stock d’intelligenza artificiale che crediamo essere rappresentative dell’intero catalogo. In secondo luogo, abbiamo utilizzato PixPlot, uno strumento sviluppato dal laboratorio di Digital Humanities di Yale.13 PixPlot permette di visualizzare grandi collezioni d’immagini all’interno di una scena WebGL interattiva. Ogni immagine viene elaborata con una Inception Convolutional Neural Network, addestrata su ImageNet 2012, e proiettata in un manifold bidimensionale con l’algoritmo UMAP (Uniform Manifold Approximation and Projection)14 in modo che immagini simili appaiano vicine l’una all’altra. Il risultato è accessibile attraverso il link in nota.15
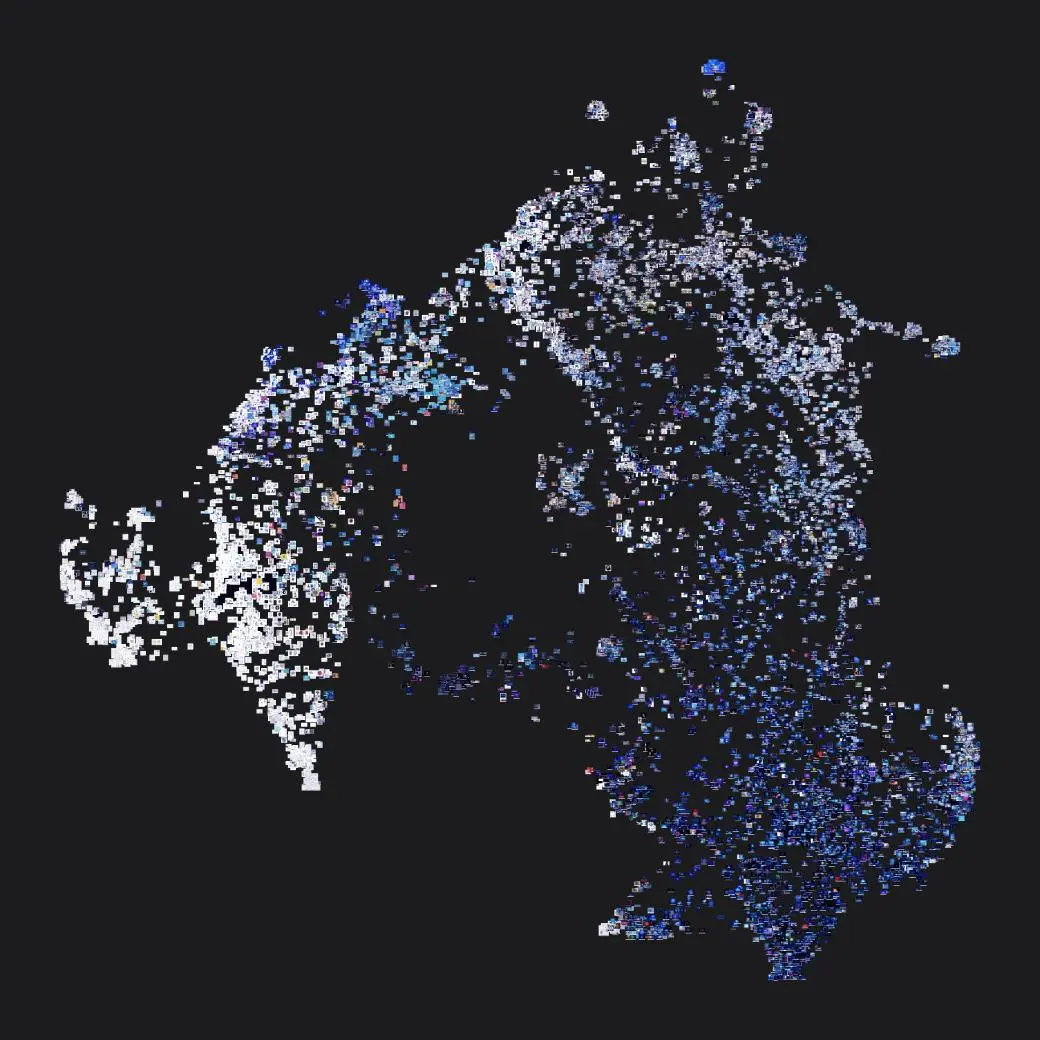
Le immagini di stock dell’intelligenza artificiale sono state automaticamente suddivise da PixPlot in dieci cluster, che abbiamo etichettato nella maniera seguente: (1) sfondo, (2) robot, (3) cervelli, (4) facce e profili, (5) laboratori e città, (6) line art, (7) Illustrator, (8) persone, (9) frammentazioni e (10) diagrammi. Per inciso, PixPlot non propone alcuna etichettatura automatica dei cluster né spiega le ragioni per cui si sono suddivise le immagini secondo questi cluster. Il lavoro di etichettatura è stato allora un lavoro deduttivo compiuto manualmente sulla base di alcune conoscenze di base sul funzionamento di simili strumenti ma anche con la piena consapevolezza della fragilità e soggettività delle nostre deduzioni. Senza dubbio, è interessante che un’intelligenza artificiale abbia il compito qui di riconoscere e suddividere le immagini di sé stessa. D’altronde, si può anche dire che è proprio l’intelligenza artificiale a selezionare la propria immagine di sé: le immagini di stock sono infatti acquistate attraverso dei motori di ricerca disponibili sui siti delle grandi agenzie. Le immagini più vendute sono probabilmente quelle che escono tra i primi risultati, secondo la logica algoritmica a cui ci ha abituati il PageRank di Google. In questo modo, i produttori d’immagini di stock sono spinti a produrre immagini che saranno potenzialmente di successo secondo questa logica. Si potrebbe ipotizzare, ma senza andare oltre qui, che la ricorrenza di pochi temi, rispetto alla grande quantità d’immagini di stock dell’intelligenza artificiale esistenti, sia anche conseguenza di tale logica algoritmica. A complicare ulteriormente la scena, si potrebbe dire che un algoritmo come PixPlot trova somiglianze tra immagini riducendole a un vettore di pixel, che poi altro non è che lo stesso progetto di frammentazione che è l’altro tema, insieme alle immagini di stock, di questo articolo.
Non possiamo né vogliamo qui descrivere ogni singola etichetta. Vogliamo invece focalizzarci sul numero (9), frammentazioni. Queste frammentazioni (dispersioni sarebbe un altro termine per nominare questo cluster) non riguardano esclusivamente i visi e i corpi; ai visi è completamente dedicato il cluster (4). Tra le immagini di frammentazione dei visi e dei corpi, ne selezioniamo in nota alcune che pensiamo siano rappresentative.16 Senza descriverle nel dettaglio, si può dire che si tratta di immagini ambigue, nel senso che suggeriscono due cose allo stesso tempo. Da una parte, suggeriscono l’idea di una macchina che diventa infine quasi-cosciente e quasi-umana. Una serie di particelle, di pixel o voxel si compongono in un viso che pare umano, di solito androgino o femminile. Lo sguardo è quasi sempre rivolto altrove, solitamente verso destra, a suggerire un tempo a venire; in maniera interessante, laddove lo sguardo coinvolge lo spettatore, come è il caso di una delle immagini il cui link è in nota, il tono diventa minaccioso. Guardando lo spettatore, la macchina si confronta direttamente con esso. Dall’altra parte, le stesse immagini (alcune in maniera più chiara di altre) suggeriscono una frammentazione dell’umano, del suo viso e del suo corpo, che si fanno per così dire quasi-macchina digitale. I colori sono asettici, tra il bianco e il blu, come è il caso di buona parte delle immagini di stock dell’intelligenza artificiale e di altre tecnologie emergenti, come il cloud computing o il quantum computing. Queste immagini lasciano pensare alla transizione da umano a macchina e viceversa. Si tratta di un immaginario comune rispetto all’intelligenza artificiale oggi: si pensi all’uso, spesso tra virgolette, che si fa di termini solitamente riservati a umani e viventi come “autonomo”, “creativo”, “intelligente” e “morale”. Fossa ha parlato di “estensione semantica” proprio per indicare l’abitudine di usare parole provenienti dall’ambito della vita per descrivere degli esseri artificiali utilizzando virgolette e simili. Nel nostro caso, si potrebbe parlare di “estensione visuale” (Fossa 2021). Ci sono ovviamente numerose questioni etiche che riguardano una simile frammentazione dei visi e dei corpi, che è anche una loro dataficazione e una loro binarizzazione. Si pensi a questo proposito, giusto per citare un esempio, alla risorgenza di approcci pseudoscientifici che ricordano da vicino la frenologia lombrosiana.17 Non è tuttavia di questo che si vuole discutere qui.
La nostra tesi è che proprio nella maniera di mostrare questa transizione da umano a macchina e viceversa per mezzo di una frammentazione o deframmentazione, simili immagini lasciano anche pensare che questi frammenti, particelle, pixel o voxel sono in fondo ciò che costituisce la realtà comune all’uomo e alla macchina, e infine al mondo, il che giustifica peraltro che il cluster (9) non riguardi solo visi e corpi. Nella loro estrema semplicità, popolarità e volgarità, queste immagini di stock sono allora portatrici di una vera e propria visione o concezione del mondo, quella che noi chiamiamo appunto una visione del mondo “a dati” o “dataficata”.
Dataficazione del mondo
Prima di parlare di dataficazione del mondo, un détour di ordine metodologico è necessario. La tesi della visione del mondo “a dati” o “dataficata” è qui ispirata ai lavori di Panofsky nell’ambito dell’iconologia nonché alle sue tesi sull’habitus o “abito mentale” del XII–XIII secolo. Famoso è l’esempio, nell’introduzione dei suoi Studi di iconologia, dell’uomo che alza il cappello per salutare un amico. Panofsky utilizza questo esempio per identificare tre livelli di osservazione e interpretazione di un’opera d’arte: (1) un livello percettivo, in cui si identifica in quel gesto una semplice serie di colori, linee e forme; (2) un livello in cui si riconosce in quel gesto un saluto. Già in (1) c’è una forma di significazione, nel senso che già nel momento in cui riconosciamo in quei colori, linee e forme un oggetto (il cappello) e un gesto (l’alzare il cappello), abbiamo superato i limiti della percezione formale e siamo entrati nel significato. Ma nel caso di (2), entriamo in un livello superiore di significazione, che possiamo chiamare secondaria o convenzionale, o ancora sociale. In effetti, per capire il significato di quel gesto, si deve essere familiari non solo col mondo pratico degli oggetti e degli eventi, ma anche col mondo “più-che-pratico” dei costumi e delle tradizioni culturali tipiche di una certa civiltà; (3) un livello “intrinseco” o “di contenuto” che ci porta dall’iconografia all’iconologia: a questo livello saranno messi in avanti tanto gli elementi più specifici (come ha esattamente sollevato il cappello quell’uomo?) che quelli più generali. A livello (3), la storia dell’arte giunge al suo fine, che consiste nel vedere in una singola opera d’arte lo stile e l’abito di un tempo, dei principi soggiacenti che ne determinano l’esistenza.18
L’iconologia di Panofsky supera i limiti della storia dell’arte per applicarsi a tutte le espressioni culturali di un’epoca. Per esempio, in Architettura gotica e filosofia scolastica, egli avanza l’ipotesi secondo cui tra il 1130–1140 e il 1270 si può osservare una connessione tra arte gotica e filosofia scolastica più concreta di un mero parallelismo, eppure anche più generale di un’influenza diretta che gli eruditi scolastici avrebbero avuto su pittori, scultori e architetti. Tra gli uni e gli altri ci sarebbe non un rapporto di causa ed effetto (secondo cui, per esempio, gli architetti sarebbero stati avidi lettori di trattati scolastici), ma di diffusione. È proprio questa diffusione che Panofsky chiama habitus o abito mentale. L’abito mentale che accomuna architetti gotici e filosofi scolastici, così come le loro opere, ha come base una rinnovata fiducia nella ragione, che può dare prova di tutto ciò che può essere dedotto da principi che non siano di fede. In particolare, Panofsky individua tre elementi o principi di somiglianza tra architettura gotica e testi scolastici: (1) totalità ovvero numerazione sufficiente, (2) arrangiamento secondo un sistema omologo di parti e di parti di parti e (3) distintività e forza di deduzione (Panofsky 2016).19
Il metodo panofskiano è stato fortemente criticato da Didi-Huberman per quel che riguarda l’arte e, più in generale, le immagini. La tesi di Didi-Huberman è che la storia dell’arte da cui veniamo e nella quale ci ritroviamo per buona parte ancora sia d’ispirazione kantiana e più precisamente neokantiana, tanto che si può parlare di un’“arte nei limiti della semplice ragione conoscente”. La responsabilità di questa situazione sarebbe da attribuirsi proprio a Panofsky, e nello specifico al Panofsky che abbandona la Germania e approda negli Stati Uniti. Didi-Huberman prende infatti in considerazione le due versioni, una del 1932 in tedesco, l’altra del 1939 in inglese, dell’articolo in cui viene introdotto l’esempio del gentiluomo che alza il cappello, un esempio preso da Mannheim.20 Già nel 1932, dice Didi-Huberman, c’erano dei termini (anch’essi risentono dell’influenza di Mannheim e delle sue considerazioni sulle visioni del mondo) quali “suprema regione” e “senso dell’essenza” per indicare lo scopo ultimo della storia dell’arte. Ma la maniera di realizzare questo progetto di sintesi era affatto diversa nel 1932: “inquieta, attraversata da qualche cosa che non era per nulla una pedagogia, ma semmai una forza che pone domande (questionnante), quasi convulsiva… e molto autenticamente filosofica” (Didi-Huberman 1990, 123). Dalla Germania agli Stati Uniti, ciò che muore è l’antitesi in favore della sintesi ottimista, positiva e anche positivistica (Didi-Huberman 1990, 128). Da un lato, Didi-Huberman riconosce la differenza dello storicismo panofskiano rispetto all’apriorismo kantiano, così come rispetto a una certa interpretazione psicologizzante di Kant. Dall’altro, egli ritiene che in fin dei conti Panofsky abbia semplicemente sostituito un universalismo (quello trascendentale o psicologizzante) con un altro, di natura storica. L’iconologia panofskiana non è meno sintesi trascendentale di quanto non lo sia il trascendentalismo kantiano, tanto che in una nota a piè di pagina, parlando della famosa interpretazione che Panofsky ha offerto dell’Allegoria della Prudenza di Tiziano, Didi-Huberman scrive che essa “non riguarda più il quadro (e il suo massivo evento colorato, per quanto scuro sia) ma un’immagine in bianco e nero […]. Nulla dell’evento propriamente pitturale è preso in conto” (Didi-Huberman 1990, 150n102). Nella prospettiva di Panofsky, la grandezza di un’opera d’arte si misura sulla base della quantità d’“energia in Weltanschauung incorporata nella materia modellata e che zampilla da questa sullo spettatore” (Panofsky citato in Didi-Huberman 1990, 154).
Insomma, Panofsky è erede nell’ambito della storia dell’arte di quella riscoperta di Kant tra fine Ottocento e inizio Novecento, che è passata per una storicizzazione e culturalizzazione (in Germania, si pensi a Cassirer) nonché socializzazione (in Francia, si pensi a Durkheim) del trascendentalismo kantiano. La tesi avanzata da Didi-Huberman è che questo lavoro di storicizzazione, culturalizzazione e socializzazione sul trascendentalismo kantiano non sia stato sufficiente, in Panofsky così come in Cassirer, Durkheim, Mauss e fino a Bourdieu (Didi-Huberman 1990, 202), a superare la tentazione sintetica che è al cuore del pensiero di Kant. Per questo motivo, egli riconduce infine la tripartizione di Panofsky da cui siamo partiti alla distinzione kantiana tra sensibilità, immaginazione e intelletto, quest’ultimo sintesi assoluta, puro intelletto e conoscenza in atto.
Se la critica di Didi-Huberman è valida, allora ogni tentativo di dedurre da poche immagini come quelle considerate nella sezione precedente un’intera visione o immagine del mondo sarebbe un atto di sintesi non meno criticabile di quello di Panofsky, anzi con l’aggravante di essere sicuramente più rozzo delle fini analisi panofskiane. Una risposta a questo vero problema metodologico ci viene però dallo stesso Didi-Huberman. Nell’ultima sezione del libro che qui consideriamo, egli avanza la sua proposta che consiste grosso modo nel riconoscere il lavoro del negativo nell’immagine, insomma nel privilegiare il sintomo (o lapsus) rispetto al segno e al discorso positivo che un’opera d’arte avanza. Invece della sintesi, si dovrebbe guardare a ciò che rende la sintesi sempre incompleta per non dire impossibile: “la nostra ipotesi è in fondo molto banale e molto semplice: in un quadro di pittura figurativa, ‘si rappresenta’ e ‘si vede’, ma qualcosa, comunque, si mostra, si guarda, ci guarda” (Didi-Huberman 1990, 189). Egli parla anche di “traccia” e “resto”, facendo un riferimento vago, in nota, al paradigma indiziario di Carlo Ginzburg, col quale dice però di non essere del tutto d’accordo (Didi-Huberman 1990, 191n44). Infine, egli riconosce il genio di Panofsky, il quale proprio a livello dell’iconologia avrebbe aperto la via al sintomo ma per chiuderla subito dopo, facendo del sintomo non qualcosa di irriducibile ma riducendolo a documento di una visione o concezione del mondo (Didi-Huberman 1990, 201).
La nostra semplice proposta metodologica consiste nel percorrere la mezza via tra Panofsky e Didi-Huberman, la quale consisterebbe nel ricorrere ai concetti di “sintomo”, “traccia” e “resto” per proporre un’epistemologia ancora positiva, ma fragile, una sintesi né assoluta, né impossibile, ma sempre aperta. Si tratterebbe di un’epistemologia della traccia e dell’indizio, proprio come il paradigma indiziario che secondo Ginzburg è al cuore delle scienze umane e sociali, e che peraltro le scienze più dure sembrano oggi sempre più inclini a seguire (Romele, in preparazione). Ciò vuol dire che quando usiamo poche immagini per mostrare un’intera visione o concezione del mondo, non vogliamo affatto chiudere la porta ad altre immagini e produzioni culturali, così come non vogliamo chiudere la porta a possibili rettificazioni e correzioni, o ancora movimenti che riguardano proprio la visione del mondo che così andiamo a disegnare e ridisegnare di continuo. Per inciso, pensiamo che la proposta di Didi-Huberman sia meno lontana da quella di Panofsky e di tutti coloro che hanno lavorato alla storicizzazione e socializzazione del trascendentalismo kantiano di quanto Didi-Huberman sia in realtà disposto ad ammettere. La differenza tra le due prospettive sta semmai nell’accento: un accento posto sull’impossibilità di sintesi nel caso di Didi-Huberman (che però non smette di sintetizzare, per esempio facendo di lapsus e sintomo l’unità prima di un metodo, proprio come aveva già fatto Freud) e sulla possibilità di sintesi malgrado tutto nel caso di Panofsky e, con lui, Cassirer, Durkheim, Bourdieu, etc. (i quali dopo tutto non smettono di porre limiti temporali e spaziali a ogni sintesi, che è sempre relativa a una cultura, a un’epoca, a una classe sociale, etc.).
Per spiegare cos’è per noi una visione del mondo “a dati” o “dataficata”, facciamo riferimento al testo dell’architetto Mario Carpo che verte sulla “seconda svolta digitale” (Carpo 2017). Il suo approccio è affascinante proprio perché in qualche misura ricorda quello di Panofsky: la conferma della sua tesi viene da un confronto tra diversi ambiti culturali, quali il design industriale, l’architettura e la filosofia.21 Secondo Carpo, l’essenza della seconda svolta digitale può essere riassunta nel motto “Search, Don’t Sort”. “Cerca, non ordinare. Usa la ricerca di Google per trovare il messaggio esatto” (in grassetto nell’originale) era la tagline sotto il logo di Gmail quando il servizio fu lanciato nel 2004. Infatti, Gmail è stato il primo servizio di posta elettronica a rendere il testo completo di tutti i messaggi di posta elettronica, inviati o ricevuti, ricercabile per parole e numeri. Secondo Carpo, questo suggerisce che la ricerca automatizzata del testo completo per parole o numeri su un intero corpus di fonti, lasciato grezzo e non ordinato, è uno strumento di recupero più potente del tradizionale processo manuale di ordinare prima gli elementi per argomento e poi cercarli nelle loro rispettive cartelle. In altre parole, data l’opulenza di dati che abbiamo a disposizione, la soluzione migliore è delegare a una macchina, un algoritmo, il compito di trovare un percorso personalizzato, parziale ed effimero di ordine e significato per noi. Le strutture arborescenti sono fatte per le menti e le memorie umane. Ma i computer funzionano diversamente.
Questa nuova prospettiva, sostiene Carpo, è diventata visibile nel design e nell’architettura contemporanei. Per lui, la curva spline (una delle novità dei primi CAD/CAM) è in qualche modo il miglior esempio della “logica dei piccoli dati” (una logica che potremmo dire informazionale e lineare) del primo stile digitale degli anni Novanta. Carpo non trascura di notare l’influenza di Deleuze e della sua nozione di “piega” nello sviluppo di questo stile curvilineo. La piega di Deleuze è in effetti una curva matematica che egli ha paragonato alle funzioni continue e all’invenzione del calcolo differenziale di Leibniz. Allo stesso modo, gli spline modeler sono strumenti che possono tradurre qualsiasi gruppo casuale di punti in linee perfettamente lisce e curve. Così, una spline è la linea più smooth che unisce un certo numero di punti fissi. Gli spline modeler sono stati importati, attraverso il lavoro di Pierre Bézier e Paul de Casteljau per Renault e Citroën, nell’architettura di Frank Gehry e del suo studio di Los Angeles. Opere come il Fish di Barcellona e il museo Guggenheim di Bilbao sono icone del primo stile architettonico guidato dal digitale. Negli ultimi anni, l’architettura di Zaha Hadid ha portato questo stile curvilineo, logaritmico e informazionale alla sua massima espressione. Ha contribuito alla costituzione di uno stile specifico chiamato “parametricismo”, che si basa su programmi, algoritmi e computer per manipolare equazioni matematiche a fini progettuali.
Secondo Carpo, questo tipo di “architettura e design orientato ai piccoli dati” è stato oggi superato dall’uso dei grandi dati e degli algoritmi di intelligenza artificiale “per mostrare la disordinata discretezza della natura così com’è, nel suo stato grezzo, senza la mediazione o la scorciatoia di eleganti e snelle notazioni matematiche. Le disordinate nuvole di punti e le unità volumetriche di disegno e calcolo che risultano da questi processi sono oggi sempre più mostrate nel loro stato apparentemente disgiunto e frammentario; e lo stile che risulta da questa modalità di composizione è spesso chiamato voxelizzazione, o voxelation” (Carpo 2017, cap. 2.7). Tra i vari esempi offerti da Carpo, ci sono gli studi sul Computational Chair Design di Philippe Morel di EZCT Architecture & Design creati con algoritmi genetici. Presentati inizialmente alla mostra ArchiLab del 2013 a Orléans, in Francia, sono stati tra le prime manifestazioni di questo nuovo approccio, che oggi comprende il lavoro di architetti, designer e artisti come Alisa Andrasek e Jose Sanchez, Marcos Cruz e Marjan Colletti, Andrew Kudless, David Ruy e Karel Klein, Jenny Sabin e Daniel Widrig.
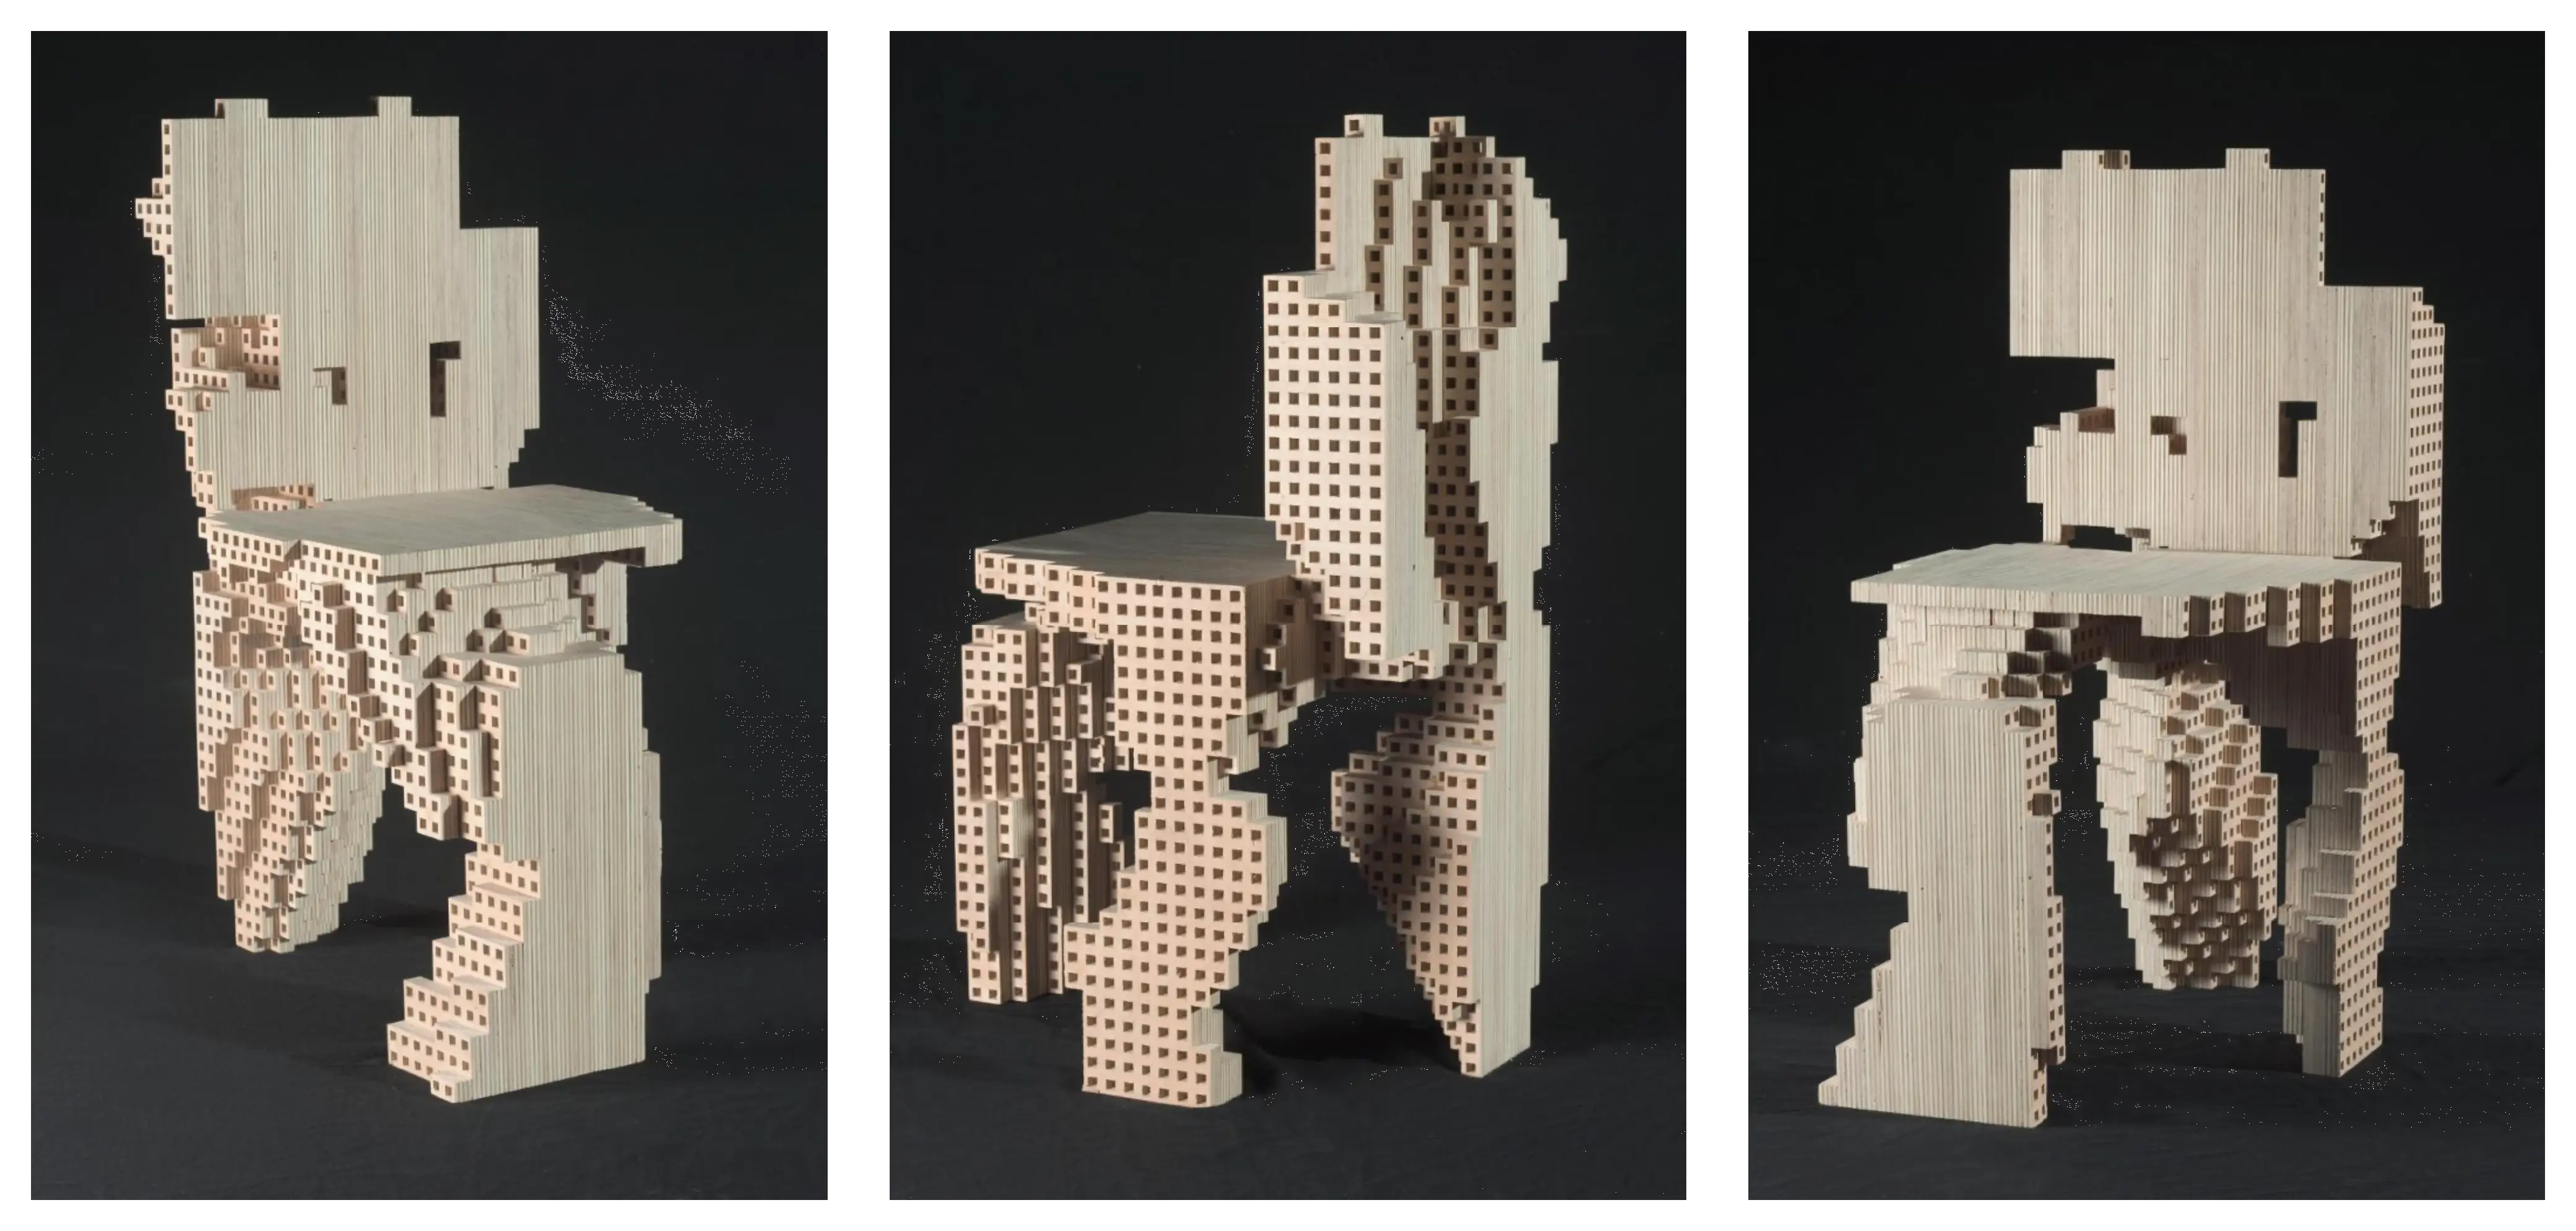
Si potrebbe allora proporre un’analogia con i tre elementi o principi proposti da Panofsky sostenendo che la visione del mondo “a dati” o “dataficata” si sostiene anch’essa su tre principi: (1) un principio di emergenza, secondo cui il significato è sempre risultato di un ordine parziale emergente più che di una struttura in cui le eccezioni sono escluse da principio; (2) un principio di instabilità, secondo cui le aggregazioni e separazioni tra parti sono sempre incerte: nuovi dati possono entrare nel calcolo algoritmico, e gli stessi algoritmi sono modificati e si modificano nel tempo; (3) un principio di deduzione senza conoscenza delle cause e delle regole (ovvero senza cogenza deduttiva). Si pensi alla maniera in cui gli algoritmi di machine learning, proprio come è il caso di PixPlot, sono in grado di ridurre una quantità enorme di dimensioni (nel caso di PixPlot, sono ben 2.048) alle due dimensioni che ci permettono la proiezione sul piano cartesiano o alle tre per una rappresentazione tridimensionale, e a noi umani non resta che cercare di capire il perché e il come, o, come in effetti accade più spesso, di rinunciarvi. Da un punto di vista visuale, nella visione del mondo a dati le linee (è bene ricordare che il rizoma di Deleuze era fatto di sole linee senza punti) sono sempre meno importanti, e sempre più importanti sono i punti, i dati, i pixel, i voxel; nella visualizzazione dei dati, per esempio, questo accade a volte per questioni di leggibilità dell’immagine, ma sempre più perché i dati sono distribuiti su spazi non relazionali a due o tre dimensioni.
Conclusione: nel blu dipinto di blu
In questo articolo abbiamo parlato di frammentazione del viso e dataficazione del mondo e della sua visione. Nella prima parte, ci siamo concentrati sulle immagini di stock dell’intelligenza artificiale e, attraverso un’analisi di tipo quali-quantitativo, abbiamo isolato un tipo di immagini specifiche che rappresentano visi, corpi e più in generale un mondo in frammentazione. Abbiamo avanzato l’ipotesi secondo cui non solo queste immagini creano un ponte tra umani e macchine, ma che esse suggeriscono in fondo che la materia stessa di umani, macchine e mondo sia il punto, il dato, il pixel o il voxel. Nella seconda parte, abbiamo prima di tutto intrapreso un lungo détour metodologico per giustificare il ricorso stesso al concetto di visione o concezione del mondo. Abbiamo poi suggerito che la maniera di vedere il mondo a dati trascende le sole immagini di stock e può ritrovarsi in produzioni culturali diverse quali quelle del design, dell’architettura e della filosofia. Non abbiamo qui parlato delle pratiche quotidiane, come il quantified self, in cui la dataficazione del mondo appare in tutta la sua forza nonché nei suoi effetti di comprensione di sé e del mondo.
Nella conclusione, vorremmo tornare sulla questione specifica delle immagini di stock dell’intelligenza artificiale. Vorremmo in particolare ritornare sul tema della rappresentabilità dell’intelligenza artificiale e sull’idea secondo cui il livello (3) (quello in cui non si rappresenta la “cosa stessa” ma le attese di senso verso di essa), a cui in buona parte le immagini di stock appartengono, deve avere le sue condizioni di verità che non dipendono, per esempio, dalla referenza all’oggetto. Questo è importante, perché è idea comune che per avere delle immagini migliori dell’intelligenza artificiale si debbano avere delle immagini “più accurate”. La nostra ipotesi è invece che si debbano avere a questo livello (3) delle immagini “pensive”. Il termine è preso da Jacques Rancière, secondo cui un’immagine è pensiva nella misura in cui è capace di mettere insieme diversi regimi di espressione (e proporre diverse vie di fuga) senza mai sintetizzarli. In altri termini, un’immagine è pensiva nella misura in cui forma delle metafore sempre aperte e mai esauste secondo diversi piani spaziali e temporali (Rancière 2008). Se esiste un problema etico nelle immagini di stock dell’intelligenza artificiale questo non si trova allora nella loro inaccuratezza ma nella loro mancanza di pensività. Col linguaggio di Didi-Huberman, si può dire che le immagini di stock dell’intelligenza artificiale non danno da pensare perché il loro significato si esaurisce nel segno e non resta alcun margine per il resto, traccia o sintomo. La mostrazione è per così dire assoluta e nulla sembra essere negato allo spettatore; ma, in questo modo, nulla viene dato a pensare allo spettatore.
Questo è chiaro, per esempio, nella predilezione per il colore blu. In Devant l’image, Didi-Huberman commenta a lungo l’Annunciazione di Fra Angelico dipinta nel 1440 nel convento di San Marco a Firenze. A suo dire, una lettura panofskiana di questa opera non può che deludere: la storia (il significato) raccontata lo è in maniera povera e scarna. Fra Angelico sembra del tutto inadatto a rappresentare la pittura italiana del Quattrocento, la quale aveva nella varietà (dettagli apocrifi, fantasie illusioniste, spazi complessi, accessori quotidiani, etc.) una delle sue qualità salienti. Per questo motivo, gli storici dell’arte fanno spesso di Fra Angelico un pittore sommario, naïf e “beato” (in senso negativo) o un mistico che guarda all’invisibile e ineffabile. La tesi di Didi-Huberman è che ci sia un’alternativa che “si fonda sull’ipotesi generale che le immagini devono la loro efficacia non solo alla trasmissione dei saperi (visibile, leggibile o invisibile) ma che al contrario la loro efficacia viene sempre dall’interlacciamento, ovvero l’imbroglio dei saperi trasmessi e dislocati, dei non saperi prodotti e trasformati” (Didi-Huberman 1990, 25). Il filosofo e critico dell’arte francese insiste soprattutto sul bianco presente nell’affresco e che si diffonde in tutta la cella in cui l’affresco è stato dipinto. Questo bianco non è niente, una mancanza, ma è qualcosa: “non è visibile nel senso di un oggetto esibito o ritagliato; ma non è nemmeno invisibile, perché impressiona il nostro occhio, e fa molto più di questo. È materia. È un insieme di particelle luminose in un caso, un polverio di particelle di calcare dall’altro. È una componente essenziale e massiva nella presentazione pitturale dell’opera. Noi diciamo che è visuale” (Didi-Huberman 1990, 26). Didi-Huberman non esita a chiamare questo bianco “sintomo”, ovvero “il nodo d’incontro di un colpo manifesto, di un’arborescenza di associazioni o di conflitti di senso” (Didi-Huberman 1990, 28). Insomma, il bianco, lungi dall’essere una mancanza, è qualcosa che nell’opera di Fra Angelico, pur non trovandosi dalla parte del segno, dice e lascia da pensare. In particolare, ciò che dice il bianco in Fra Angelico è il senso stesso dell’Annunciazione, che Alberto Magno e i suoi discepoli vedevano non solo come un evento unico, ma anche come “fioritura assolutamente stravagante di sensi inclusi o associati, di avvicinamenti virtuali, di memorie, profezie che riguardano ogni cosa, dalla creazione di Adamo fino alla fine dei tempi, dalla semplice forma della lettera M (l’iniziale di Maria) fino alla prodigiosa costruzione delle gerarchie celesti” (Didi-Huberman 1990, 31). Il bianco di Fra Angelico è un mezzo di figurabilità del mistero dell’Incarnazione, proprio perché quel bianco, come l’Incarnazione, si trova già sempre altrove rispetto alla presenza del segno. Nelle parole di Didi-Huberman:
Esso è dunque una superficie d’esegesi, nel senso in cui si potrebbe parlare di superficie di divinazione. Esso cattura lo sguardo per provocare la catena incontrollabile di immagini suscettibili di intrecciare un filo virtuale attorno al mistero che congiunge l’angelo e la Vergine in questo affresco. Questo bianco frontale non è nulla di più che una superficie di contemplazione, uno schermo di sogno, ma dove tutti i sogni sono possibili. (Didi-Huberman 1990, 34)22
Come dicevamo, nell’uso massivo del colore blu nelle immagini di stock si può vedere il problema etico di queste immagini che consiste, in fondo, nella loro mancanza di pensività, o nella loro incapacità di aprire infinite o almeno molteplici vie di significazione come fa invece il colore bianco in Fra Angelico.23 Al contrario, l’uso del colore blu finisce per chiudere, restringere, in maniera simile a quello che i sociologi della tecnica chiamano lock-in, ma che qui non è più inteso in termini tecnici, economici, ovvero materiali, ma in termini di immaginari e forme simboliche che, incarnati in espressioni culturali, hanno degli effetti concreti tanto sulle attese di senso, quanto sui processi di innovazione.
Nella sua storia del colore blu, Michel Pastoureau (2000) distingue quattro fasi: (1) una fase discreta, fino al XII secolo, in cui il colore è quasi assente, anche perché difficile da creare e utilizzare, con la sola eccezione dell’indaco; (2) un’esplosione del blu tra il XII e il XIV secolo, in cui il blu, come l’oro, diviene sinonimo di luce divina. Il blu diventa per esempio il colore dell’abito della Vergine (prima, i colori erano scuri, come il nero e un certo rosso; dopo, per esempio nell’arte barocca, sarà il colore oro a trionfare; infine, a partire dall’adozione del dogma dell’Immacolata Concezione, sarà il bianco, sinonimo di purezza e verginità). A quest’epoca, tra l’altro, il blu comincia a essere un colore regale; (3) tra il XV e il XVII secolo, il blu diventa un colore “morale”, per non parlare del fatto che in quest’epoca il blu diventa segno di prestigio, non tanto del pittore, ma del suo ricco committente, visti i costi elevati della tinta; (4) infine, a partire dal XVIII secolo, il blu si popolarizza, per diventare oggi il colore statisticamente preferito al mondo. Prima di IBM, che è chiamata appunto The Big Blue, ci sono stati i blue jeans della Levi’s, il blu di Madame Bovary (il blu è dappertutto nel romanzo di Flaubert e, d’altronde, Rouen era uno dei centri più importanti per la tinta indaco e blu; il blu Bovary non è solo stato d’animo ma anche condizione sociale)24 e il blu del giovane Werther.
Ora, secondo Pastoureau, il successo del blu oggi non è l’espressione di qualche pulsione: si ha persino l’impressione che sia proprio perché il blu è meno marcato simbolicamente che fa oggi l’unanimità nel gusto. In fondo, il blu “è calmo, pacifico, lontano, […] certo fa sognare, […] ma questo sogno melanconico ha qualche cosa d’anestetizzante” (Pastoureau 2000, 159). D’altronde, non è un caso che l’ONU, l’UNESCO e la Comunità Europea siano blu, e persino la polizia (che in Italia chiamiamo, in senso spregiativo, i Puffi) sia anch’essa blu. Secondo noi, l’uso del blu nelle immagini di stock dell’intelligenza artificiale ha, se non proprio una funzione, per lo meno un effetto anestetizzante. Invece di aprire, per esempio a diverse interpretazioni in conflitto tra loro, a un dibattito pubblico sull’intelligenza artificiale, esse finiscono per chiudere, calmare e rassegnare. L’uso del blu nelle immagini di stock dell’intelligenza artificiale è insomma diametralmente opposto all’uso del bianco da parte di Fra Angelico. Così succede che quelle immagini di stock che rappresentano l’intelligenza artificiale in termini di frammentazione del viso, del corpo e del mondo, finiscono per risultare ovvie, nel senso che ciò che con esse è veicolato, ovvero un’immagine del mondo “a dati” o “dataficata”, prende la forma del certo e dell’indisputabile.
Bibliografia
- Aiello, Giorgia e Alison Woodhouse. 2016. “When Corporations Come to Define the Visual Politics of Gender: The Case of Getty Images.” Journal of Language and Politics 15 (3): 352–68.
- Alpaydin, Ethem. 2016. Machine Learning: The New AI. Cambridge, MA: MIT Press.
- Carpo, Mario. 2017. The Second Digital Turn: Design Beyond Intelligence. Cambridge, MA: MIT Press.
- Cave, Stephen e Kanta Dihal. 2020. “The Whiteness of AI.” Philosophy & Technology 33 (4): 685–703.
- Coopmans, Catelijne, Janet Vertesi, Michael E. Lynch e Steve Woolgar, a cura di. 2014. Representation in Scientific Practice Revisited. Cambridge, MA: MIT Press.
- Crawford, Kate e Trevor Paglen. 2019. “Excavating AI: The Politics of Images in Machine Learning Training Sets.” https://excavating.ai/.
- Didi-Huberman, Georges. 1990. Devant l’image: Question posée aux fins d’une histoire de l’art. Parigi: Les Éditions de Minuit.
- Didi-Huberman, Georges. 1995. Fra Angelico: Dissemblance et figuration. Parigi: Flammarion.
- Falcinelli, Riccardo. 2017. Cromorama: Come il colore ha cambiato il nostro sguardo. Torino: Einaudi.
- Fossa, Fabio. 2021. “Artificial Agency and the Game of Semantic Extension.” Interdisciplinary Science Reviews 46 (4): 440–57.
- Frosh, Paul. 2003. The Image Factory: Consumer Culture, Photography and the Visual Content Industry. Oxford: Berg.
- Frosh, Paul. 2013. “Beyond the Image Bank: Digital Commercial Photography.” In The Photographic Image in Digital Culture, a cura di Martin Lister, 131–48. Londra e New York: Routledge.
- Ihde, Don. 1990. Technology and the Lifeworld: From Garden to Earth. Bloomington: Indiana University Press.
- Jones, Caroline A. e Peter Galison, a cura di. 1998. Picturing Science, Producing Art. New York e Londra: Routledge.
- Latour, Bruno. 2015. Non siamo mai stati moderni. Milano: elèuthera.
- Lynch, Michael E. e Steve Woolgar, a cura di. 1990. Representation in Scientific Practice. Cambridge, MA: MIT Press.
- Panofsky, Erwin. 1999. Studi di iconologia: I temi umanistici nell’arte del Rinascimento. Torino: Einaudi.
- Panofsky, Erwin. 2013. La prospettiva come forma simbolica. Milano: Abscondita.
- Panofsky, Erwin. 2016. Architettura gotica e filosofia scolastica. Milano: Abscondita.
- Pastoureau, Michel. 2000. Bleu: Histoire d’une couleur. Parigi: Seuil.
- Rancière, Jacques. 2008. Le spectateur émancipé. Parigi: La Fabrique.
- Romele, Alberto. 2014. “La Weltanschauungslehre di Dilthey e alcune variazioni sulla sua ricezione.” In Modernità e progresso: Due parole guida nella storia del pensiero, a cura di Gregorio Piaia e Ivana Manova, 207–28. Padova: Cleup.
- Romele, Alberto. In preparazione. “Carlo Ginzburg.” In Interprétation: Dictionnaire des auteurs, a cura di Christian Berner, Jean-Claude Gens, Johann Michel e Denis Thouard. Parigi: Vrin.
- Thurlow, Crispin, Giorgia Aiello e Lara Portmann. 2020. “Visualizing Teens and Technology: A Social Semiotic Analysis of Stock Photography and News Media Imagery.” New Media & Society 22 (3): 528–49.
-
https://www.thehairpin.com/2011/01/women-laughing-alone-with-salad/ (archivio). Tutti i siti internet e documenti online sono stati consultati il 15 ottobre 2021. ↩
-
https://www.thehairpin.com/2011/11/women-struggling-to-drink-water/ (archivio). ↩
-
Il riferimento è qui alle relazioni ermeneutiche di cui parla il filosofo della tecnica Don Ihde, padre di quella corrente chiamata “postfenomenologia”. Si veda per esempio Ihde (1990). ↩
-
Come mostra bene il titolo del libro di Alpaydin (2016). ↩
-
Si veda a questo proposito il progetto imagemesh.ai, in cui viene fatto lo scraping di immagini provenienti da articoli scientifici sull’intelligenza artificiale disponibili in pre-print su arXiv. ↩
-
Si vedano le due iniziative NotMyRobots! (https://notmyrobot.home.blog/) e Better Images of AI (https://blog.betterimagesofai.org/). ↩
-
Per esempio, particle-digital-face-concept-design, man-face-pixel-dispersion-effect e artificial-intelligence-ai-deep-learning. ↩
-
Si veda a questo proposito il lavoro di critica sui set d’immagini con cui vengono allenati gli algoritmi (come ImageNet e, riguardo ai visi nello specifico, il più recente “Diversity in Faces” di IBM) condotto da Crawford e Paglen (2019). ↩
-
La descrizione di (1) e (2) è effettivamente presa da Panofsky (1999). Per (3) abbiamo invece usato Didi-Huberman (1990). ↩
-
Esemplare è il confronto tra la Porta del Giudizio della cattedrale di Notre-Dame a Parigi e la struttura della prima parte della Summa di Tommaso. ↩
-
La versione del 1939, trasformata a due riprese nel 1955 e nel 1962, è quella che viene messa in introduzione agli Studi di iconologia. La versione del 1932, pubblicata sulla rivista Logos (XXI) col titolo “Zum Problem der Beschreibung und Inhaltsdeutung von Werken der bildenden Kunst”, è stata poi inserita ne La prospettiva come forma simbolica (Panofsky 2013). ↩
-
Esiste tuttavia anche una differenza importante. Carpo ha la tendenza a leggere le trasformazioni nell’ambito dell’architettura e del design come risultato di certe implementazioni tecniche, soprattutto digitali, nel lavoro di architetti e designer. In questo modo, a volte il suo discorso risulta determinista. Noi preferiamo invece una prospettiva à la Panofsky, che si limita a osservare delle “arie di famiglia” che non possono essere ricondotte a una relazione di causa ed effetto. ↩
-
D’altronde, come spiega nei dettagli Didi-Huberman altrove (1995), il mistero dell’Incarnazione è la sola chiave di lettura adeguata di tutta la pittura di Fra Angelico. La maniera in cui Fra Angelico dà risposta a questo mistero è la dissomiglianza, che non è messa in gioco con la pittura dei segni ma piuttosto degli indizi e dei sintomi. Laddove gli storici dell’arte si concentrano sulla figura, ovvero l’oggetto del quadro, Didi-Huberman propone di concentrarsi sullo sfondo, e di fare di questo sfondo la vera figura. È nello sfondo e con esso, infatti, che Fra Angelico rende conto dell’Incarnazione. Esempio ne sono delle piccole macchie rosse che si possono vedere sull’affresco Noli me tangere, dipinto verso il 1438–1450 anche questo nel convento di San Marco a Firenze. Queste macchie sono tutt’altro che secondarie rispetto all’immagine rappresentata: vanno dalle mani e dai piedi di Cristo, a rappresentare le stimmate, fino al giardino, in cui rappresentano i fiori. Insieme, ricordano l’atto di Cristo di seminare le sue stimmate sul giardino del mondo terrestre appena prima di raggiungere, ascendendo al cielo, la destra del Padre (Didi-Huberman 1995, 38). ↩
-
Il bianco, pur abbondante nelle immagini di stock, non è certo il bianco di Fra Angelico, o almeno non ha certo lo stesso ruolo. Per una riflessione sull’uso del bianco nelle rappresentazioni dell’intelligenza artificiale, si veda Cave e Dihal (2020). ↩
-
Si veda Falcinelli (2017), in cui un intero capitolo è dedicato al blu Bovary. ↩